前些天发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,忍不住给大家分享一下。点击跳转到网站:https://www.captainai.net/dongkelun
前言
和上篇文章Hudi Flink SQL源码调试学习(一)一样:本着学习hudi-flink源码的目的,利用之前总结的文章中的代码进行调试,记录调试学习过程中主要的步骤及对应源码片段。
本文主要总结 Flink 的 Transformation、StreamOperator, 写Hudi与 Transformation、StreamOperator的关系以及Hudi有哪些自定义的 StreamOperator,还有Flink的四层执行图以及 StreamGraph 和 JobGraph 的生成构建过程。
版本
- Flink 1.15.4
- Hudi 0.13.0
Transformation & StreamOperator
通过阅读Hudi源码,发现写Hudi的主要逻辑在Pipelines中的hoodieStreamWrite、append、bulkInsert、compact、cluster等方法中。而这几个方法的主要逻辑都用到了transform这个方法,transform返回结果为DataStream,执行完transform方法后最终会执行dataStream.addSink完成写Hudi逻辑。而transform和addSink方法又主要与Transformation、StreamOperator(StreamOperatorFactory)这两个类有关,实际上写Hudi的主要逻辑就是在Hudi自定义的StreamOperator和SinkFunction中实现的。
HoodieTableSink.getSinkRuntimeProvider
1 | // bootstrap |
Pipelines.hoodieStreamWrite
1 | public static DataStream<Object> hoodieStreamWrite(Configuration conf, DataStream<HoodieRecord> dataStream) { |
Pipelines.clean
1 | public static DataStreamSink<Object> clean(Configuration conf, DataStream<Object> dataStream) { |
transform
hudi源码里用到了两个transform方法,两个方法的区别只是参数不同,一个参数为StreamOperator,一个为StreamOperatorFactory,实际都会调用doTransform方法
1 |
|
doTransform
doTransform的主要逻辑是先构造Transformation,Transformation的构造函数中包含StreamOperatorFactory,然后将Transformation添加到StreamExecutionEnvironment的transformations中,最后返回一个新的DataStream,这里的DataStream为SingleOutputStreamOperator,它是DataStream的子类(注意SingleOutputStreamOperator不是上面提到的StreamOperator),它和之前的DataStream的不同点是transformation,新生成的DataStream的transformation是这里的resultTransform
1 | protected <R> SingleOutputStreamOperator<R> doTransform( |
addSink
可以看到addSink方法会调用DataStreamSink.forSinkFunction方法,在forSinkFunction中也会构建StreamOperator、Transformation,然后将Transformation添加到StreamExecutionEnvironment的transformations中,不同的是最后返回DataStreamSink。这里的StreamOperator为StreamSink
1 | public DataStreamSink<T> addSink(SinkFunction<T> sinkFunction) { |
Hudi自定义的StreamOperator
Pipelines.hoodieStreamWrite
KeyedProcessOperator(BucketAssignFunction): KeyedProcessOperator是Flink源码中自带的:org.apache.flink.streaming.api.operators.KeyedProcessOperator。这里的Hudi自定义体现在自定义了Operator的userFunction: org.apache.hudi.sink.partitioner.BucketAssignFunctionStreamWriteOperator: org.apache.hudi.sink.StreamWriteOperator,userFunction为:org.apache.hudi.sink.StreamWriteFunctionBucketStreamWriteOperator:org.apache.hudi.sink.bucket.BucketStreamWriteOperator,userFunction为:org.apache.hudi.sink.bucket.BucketStreamWriteFunction
Pipelines.append
AppendWriteOperator: org.apache.hudi.sink.append.AppendWriteOperator,userFunction为:org.apache.hudi.sink.append.AppendWriteFunction
Pipelines.bulkInsert
BulkInsertWriteOperator: org.apache.hudi.sink.bulk.BulkInsertWriteOperator,userFunction为:org.apache.hudi.sink.bulk.BulkInsertWriteFunctionSortOperator: org.apache.hudi.sink.bulk.sort.SortOperator
Pipelines.compact
CompactionPlanOperator: org.apache.hudi.sink.compact.CompactionPlanOperatorCompactOperator: org.apache.hudi.sink.compact.CompactOperator
Pipelines.cluster
ClusteringPlanOperator: org.apache.hudi.sink.clustering.ClusteringPlanOperatorClusteringOperator: :org.apache.hudi.sink.clustering.ClusteringOperator
Hudi自定义的SinkFunction
DummySink: org.apache.hudi.sink.utils.Pipelines.DummySink. Dummy sink that does nothing. (Pipelines.bulkInsert & Pipelines.dummySink)ClusteringCommitSink: org.apache.hudi.sink.clustering. Function to check and commit the clustering action. (Pipelines.cluster)CompactionCommitSink: org.apache.hudi.sink.compact.CompactionCommitSink. Function to check and commit the compaction action. (Pipelines.compact)CleanFunction: org.apache.hudi.sink.CleanFunction. Sink function that cleans the old commits. (Pipelines.clean)
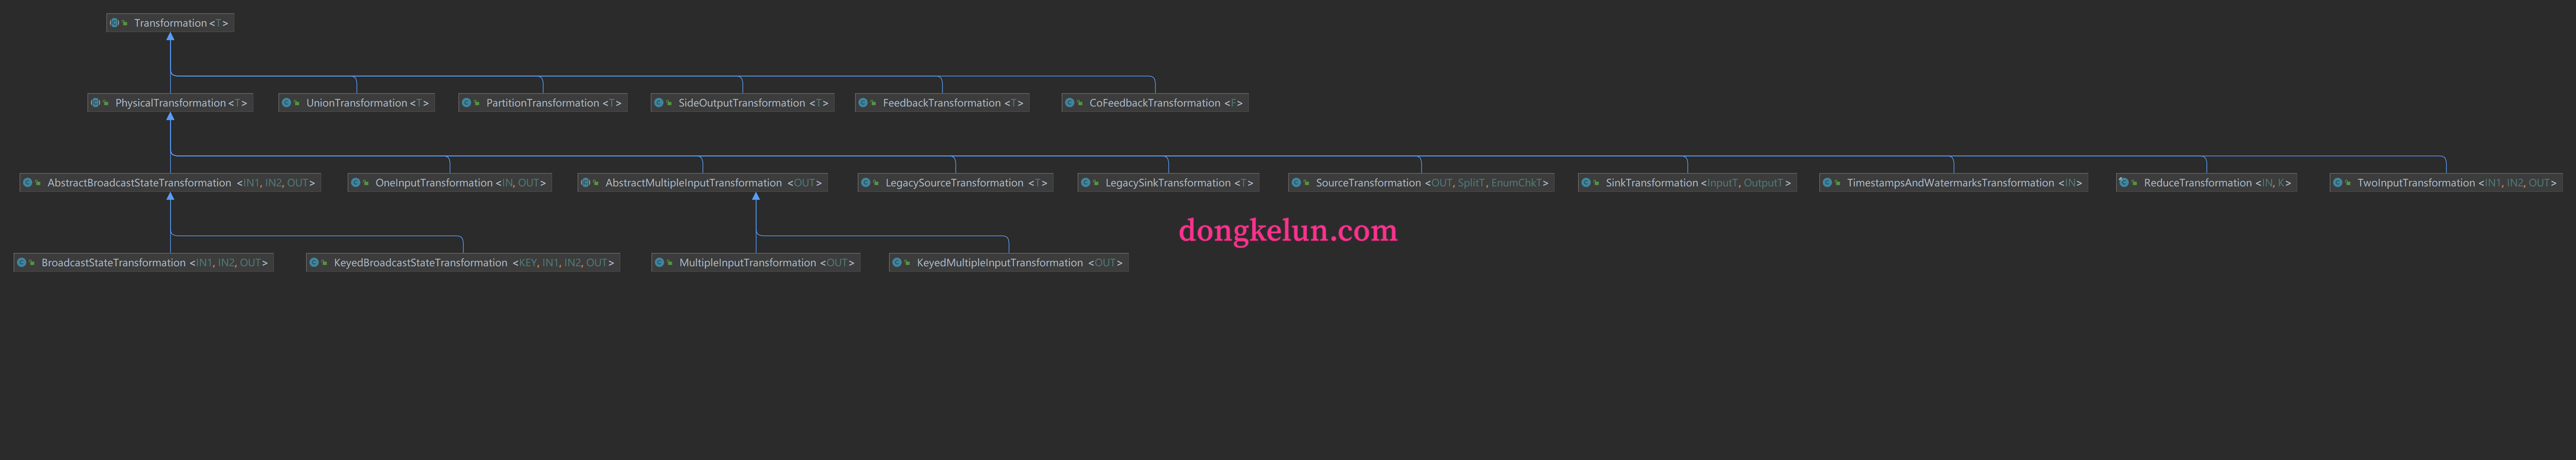
Transformation 类图
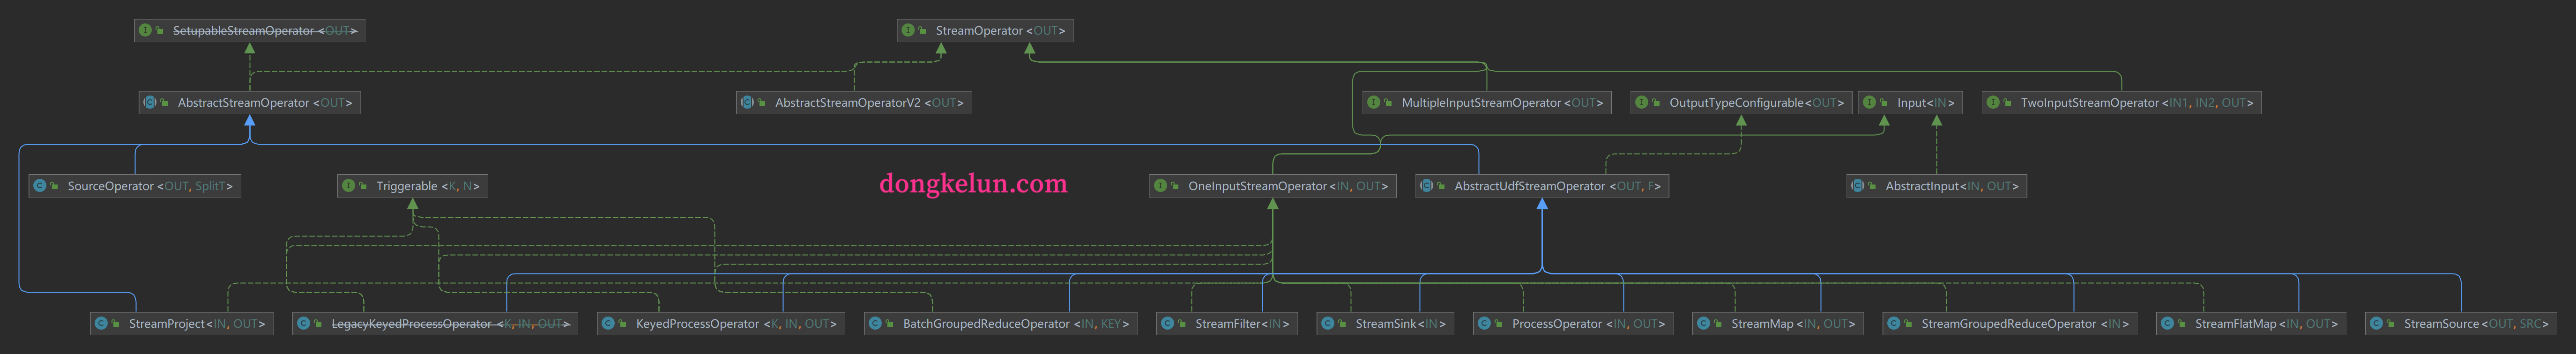
StreamOperator 类图
目标
虽然大概知道hudi-flink的主要逻辑就是在Hudi自定义的StreamOperator和SinkFunction中实现的,但由于我是个Flink新手,并不知道从DataStream API和 Table API的入口到执行StreamOperator的调用链或者执行逻辑,所以本篇文章的目的就是研究总结下Flink从最开始入口到StreamOperator的调用逻辑。这其实都是Flink的源码和Hudi没有关系,但是我们可以结合Hudi自定义的StreamOperator更好的理解。这块逻辑其实就是研究 Flink 的 Task 或者 Function 是如何运行的(可能描述不准确)。
网上查询相关资料,大概了解了一下相关源码,发现逻辑比较复杂,大概包含StreamGraph、JobGraph、ExecutionGraph、Physical Graph(没有具体的数据结构,这一步也可以理解为Task的运行)
的生成或者构建,还有JobManager和TaskManager的启动,而JobManager又包含ResourceManager、Dispatcher和JobMaster, 这里涉及Java8异步编程如CompletableFuture和基于Akka的RPC通信,最后才是Task的的部署和启动,StreamOperator相关方法的调用最终是通过启动Task.run方法在StreamTask中实现的。
可以看出来这块逻辑对于新手来说相当复杂,而且我的精力也有限,所以本篇文章先分析总结StreamGraph和JobGraph。
参考资料
Flink 架构官方文档:https://nightlies.apache.org/flink/flink-docs-release-1.17/zh/docs/concepts/flink-architecture/
Flink 词汇表官方文档:https://nightlies.apache.org/flink/flink-docs-release-1.17/zh/docs/concepts/glossary/
Flink 源码阅读笔记 (Flink Contributor jrthe42):https://blog.jrwang.me/page/3/
Flink 源码分析: https://www.zhihu.com/column/c_1494627744968962048
CompletableFuture: https://blog.csdn.net/qq_31865983/article/details/106137777
CompletableFuture: https://blog.csdn.net/sermonlizhi/article/details/123356877
Akka: https://blog.csdn.net/monokai/category_10204213.html?spm=1001.2014.3001.5515
Transformation: https://blog.csdn.net/weixin_39043378/article/details/123962394
Flink 四层执行图
StreamGraph(Client端) -> JobGraph(Client端) -> ExecutionGraph(JobManager创建JobMaster时) -> Physical Graph(物理执行图)(TaskManager)(没有具体的数据结构,这一步也可以理解为Task的运行)
由于官方文档对四层执行图的解释不全,且和网上博客资料不太一致,所以我将博客资料和官方文档的解释放在一起了,供大家参考。参考博客:https://blog.csdn.net/Yohohaha/article/details/111400250
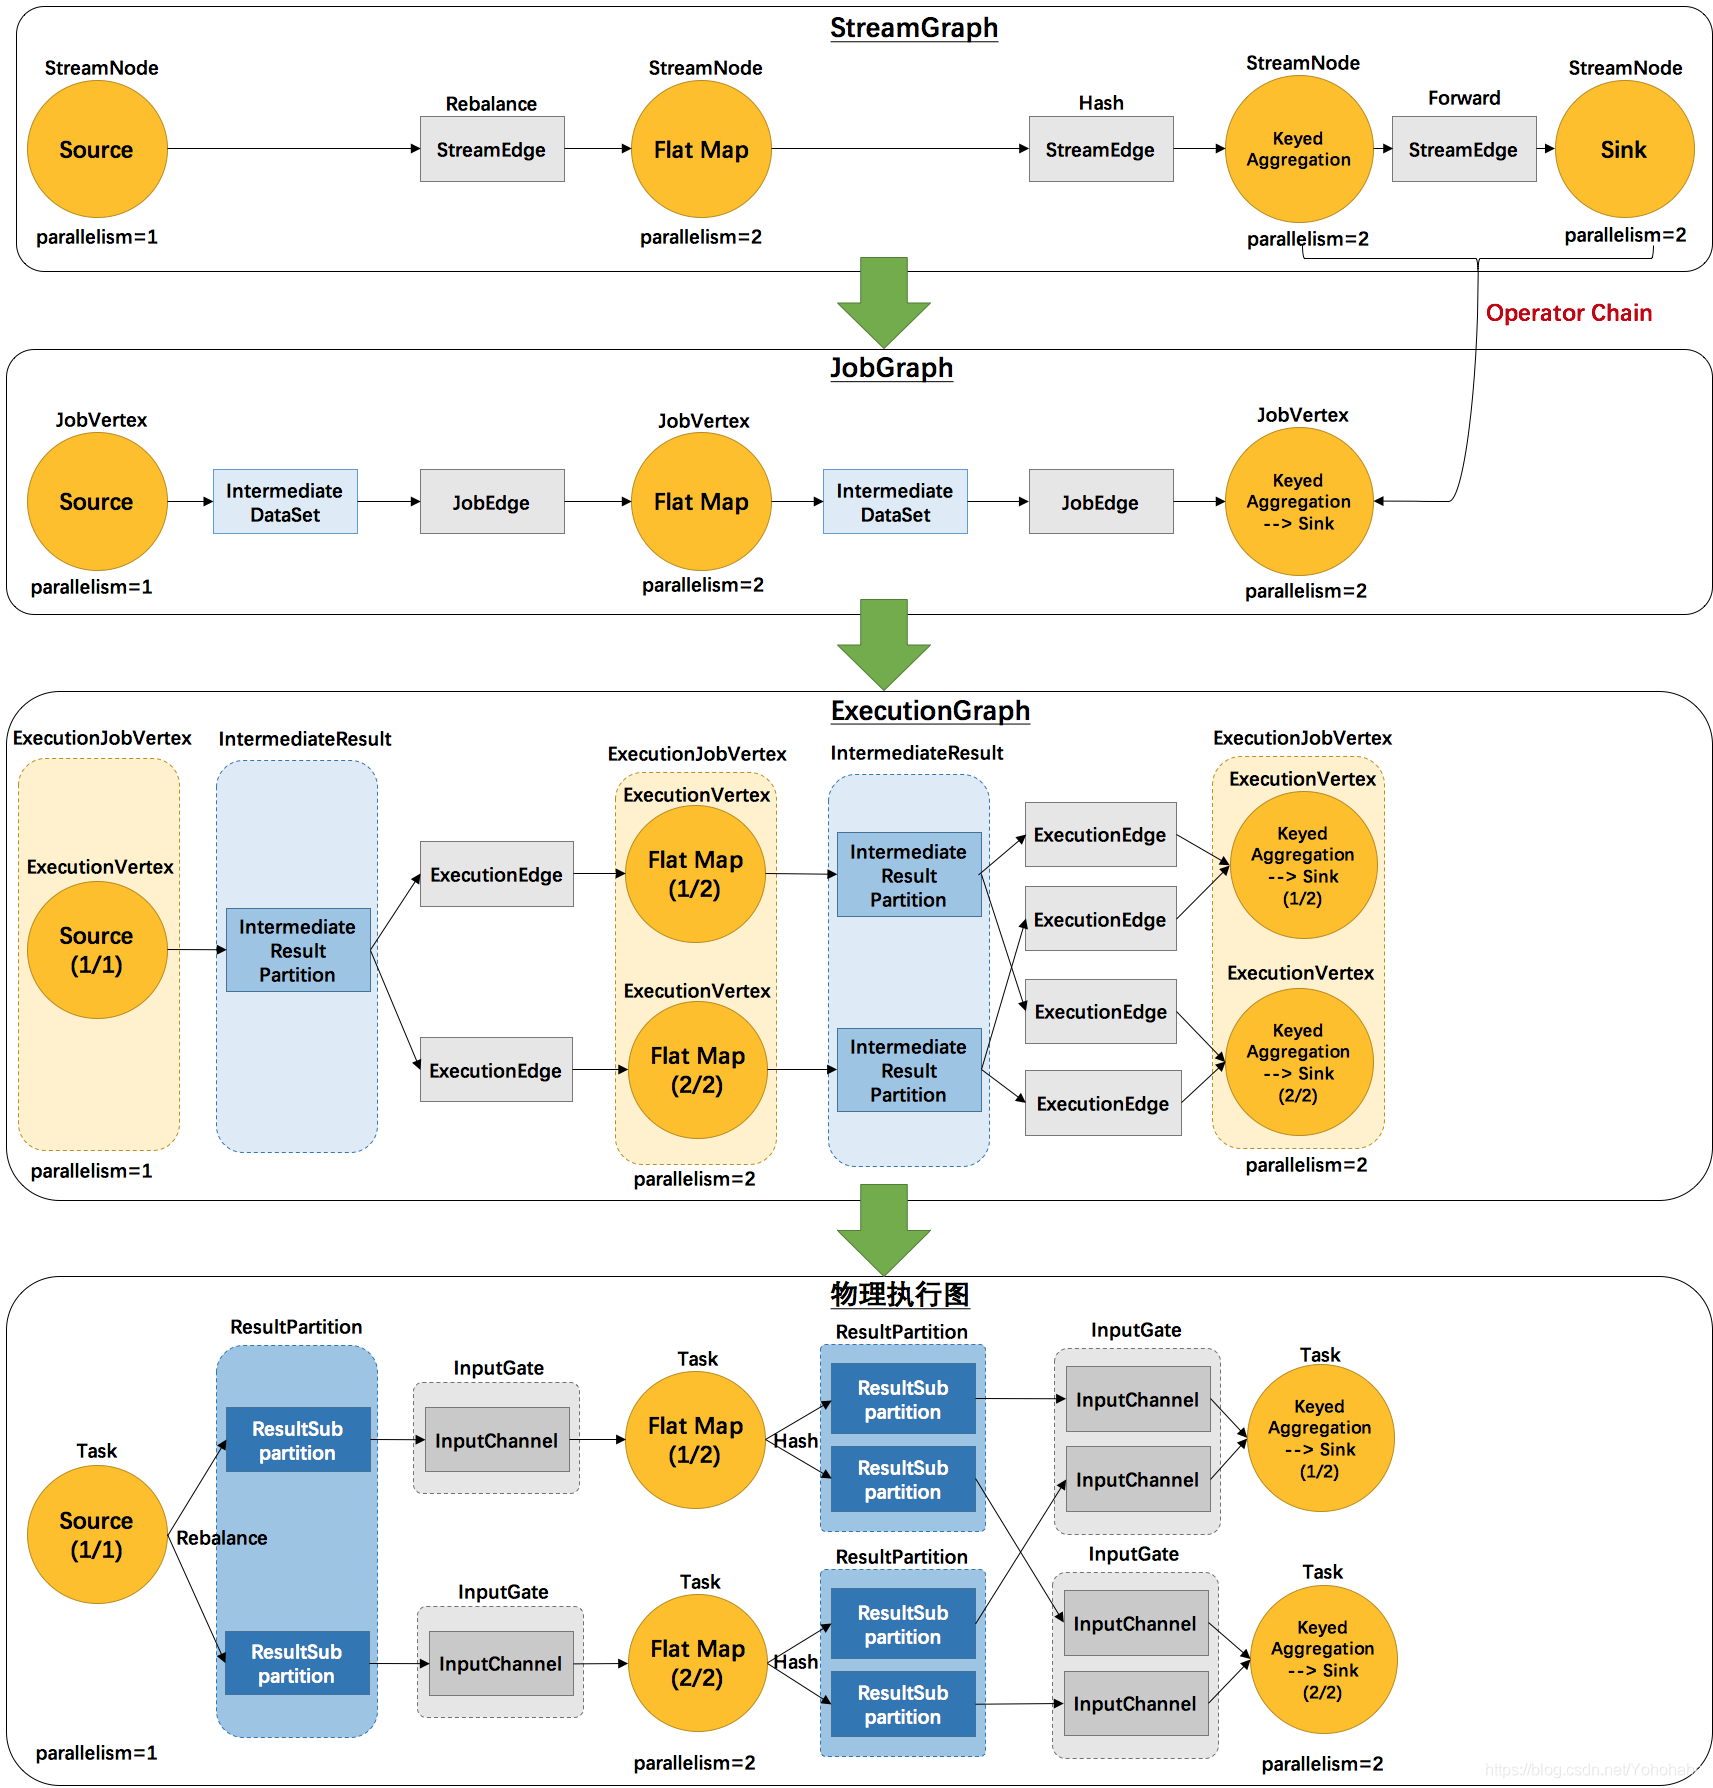
StreamGraph:是根据用户通过 Stream API 编写的代码生成的最初的图,用来表示程序的拓扑结构。每个转换操作会生成一个StreamNode,两个StreamNodes之间由StreamEdge连接在一起,StreamEdge表示的是算子操作之间的数据传递逻辑,整个图直观表现就是各个算子连接在一起形成一个DAG。官方文档: 无JobGraph:StreamGraph经过优化后生成了JobGraph,提交给JobManager的数据结构。在一步做了一个优化,就是将多个符合条件的StreamNode节点 chain 在一起作为一个JobVertex节点,这样可以减少数据在节点之间流动所需要的序列化/反序列化/传输消耗。JobGraph在Client端生成。官方文档: 也叫Logical Graph,逻辑图是一种有向图,其中顶点是 算子,边定义算子的输入/输出关系,并对应于数据流或数据集。通过从 Flink Application 提交作业来创建逻辑图。逻辑图通常也称为数据流图。ExecutionGraph:JobManager根据JobGraph生成ExecutionGraph。ExecutionGraph是JobGraph的并行化版本:一个JobVertex对应一个ExecutionJobVertex,根据一个JobVertex的并行度(一个Task可以并行在不同的TaskManager上执行),生成相对应数量的ExecutionVertex。同时在这个图中多了一层IntermediateResult,表示执行的中间结果。IntermediateResult与ExecutionJobVertex之间通过ExecutionEdge形成连接。ExecutionGraph是调度层最核心的数据结构,JobManager通过它来调度任务的执行。ExecutionGraph是JobMaster的成员,构建发生在JobMaster的构造方法中。官方文档:见Physical Graph。Physical Graph是一个在分布式运行时,把Logical Graph转换为可执行的结果。节点是Task,边表示数据流或数据集的输入/输出关系或partition。Physical Graph:JobManager根据ExecutionGraph对Job进行调度后,在各个TaskManager上部署Task后形成的“图”,与ExecutionGraph基本保持一致。它只是一个任务执行状态的逻辑展示,并不是一个具体的数据结构。官方文档:Physical graph是一个在分布式运行时,把Logical Graph转换为可执行的结果。节点是Task,边表示数据流或数据集的输入/输出关系或partition。
相关词汇
JobManager: Flink JobManager 是 Flink Cluster 的主节点。它包含三个不同的组件:Flink Resource Manager、Flink Dispatcher、运行每个 Flink Job 的 Flink JobMaster。TaskManager: TaskManager 是 Flink Cluster 的工作进程。Task 被调度到 TaskManager 上执行。TaskManager 相互通信,只为在后续的 Task 之间交换数据。关于
JobManager和TaskManager可以查看 Flink 架构官方文档:https://nightlies.apache.org/flink/flink-docs-release-1.17/zh/docs/concepts/flink-architecture/Job: Flink Job 表示为 runtime 的 logical graph(通常也称为数据流图),通过在 Flink Application 中调用 execute() 方法来创建和提交 。Operator: Logical Graph 的节点。算子执行某种操作,该操作通常由 Function 执行。Source 和 Sink 是数据输入和数据输出的特殊算子。Function: Function 是由用户实现的,并封装了 Flink 程序的应用程序逻辑。大多数 Function 都由相应的 Operator 封装。Task: Task 是 Physical Graph 的节点。它是基本的工作单元,由 Flink 的 runtime 来执行。Task 正好封装了一个 Operator 或者 Operator Chain 的 parallel instance。Transformation: Transformation 应用于一个或多个数据流或数据集,并产生一个或多个输出数据流或数据集。Transformation 可能会在每个记录的基础上更改数据流或数据集,但也可以只更改其分区或执行聚合。虽然 Operator 和 Function 是 Flink API 的“物理”部分,但 Transformation 只是一个 API 概念。具体来说,大多数(但不是全部)Transformation 是由某些 Operator 实现
相关类
StreamExecutionEnvironmentLocalStreamEnvironmentTableEnvironmentImplDefaultExecutorStreamGraphGeneratorLocalExecutorPipelineExecutorUtilsFlinkPipelineTranslationUtilStreamGraphTranslatorStreamGraphStreamingJobGraphGenerator
调试代码
- DataStream API: Hudi Flink SQL代码示例及本地调试
- Table API: Flink Hudi DataStream API代码示例
入口
DataStream API 的入口比 Table API 的入口更直观更好找(或者更容易理解)
DataStream API
1 | env.execute |
Table API
tableEnv.executeSql -> TableEnvironmentImpl.executeSql -> executeInternal(Operation operation) -> executeInternal(List<ModifyOperation> operations)
1 | tableEnv.executeSql |
executeInternal(List<ModifyOperation> operations)
1 | public TableResultInternal executeInternal(List<ModifyOperation> operations) { |
StreamGraph
虽然入口不一样,但是 DataStream API 和 Table API 最终都是通过 StreamExecutionEnvironment 的 getStreamGraphGenerator(transformations).generate() 继而通过 StreamGraphGenerator.generate 生成 StreamGraph的
DataStream API
StreamExecutionEnvironment.execute->StreamExecutionEnvironment.getStreamGraph
env(LocalStreamEnvironment)
1 | public class LocalStreamEnvironment extends StreamExecutionEnvironment { |
StreamExecutionEnvironment.execute
1 | public JobExecutionResult execute(String jobName) throws Exception { |
StreamExecutionEnvironment.getStreamGraph
1 | public StreamGraph getStreamGraph() { |
Table API
TableEnvironmentImpl.executeSql->executeInternal(Operation operation)->executeInternal(List<ModifyOperation> operations)->executeInternal(transformations, sinkIdentifierNames)->DefaultExecutor.createPipeline->StreamExecutionEnvironment.generateStreamGraph
1 | private TableResultInternal executeInternal( |
DefaultExecutor.createPipeline
1 |
|
StreamExecutionEnvironment.generateStreamGraph
1 | public StreamGraph generateStreamGraph(List<Transformation<?>> transformations) { |
公共部分
StreamExecutionEnvironment.getStreamGraphGenerator->StreamGraphGenerator.generate
StreamExecutionEnvironment.getStreamGraphGenerator
1 | private StreamGraphGenerator getStreamGraphGenerator(List<Transformation<?>> transformations) { |
StreamGraphGenerator.generate
1 | public StreamGraph generate() { |
到这里
StreamGraph就生成了,它是在 Client 端生成的
JobGraph
从分析生成 StreamGraph的源码中可知,生成StreamGraph之后接下来就是生成 JobGraph。
DataStream API 和 Table API 都是在StreamExecutionEnvironment.executeAsync方法中最终通过 StreamingJobGraphGenerator.createJobGraph 生成JobGraph的
DataStream API
StreamExecutionEnvironment.execute->LocalStreamEnvironment.execute(streamGraph)->StreamExecutionEnvironment.execute(streamGraph)->StreamExecutionEnvironment.executeAsync
回到
StreamExecutionEnvironment.execute,LocalStreamEnvironment.execute(streamGraph)
1 | public JobExecutionResult execute(StreamGraph streamGraph) throws Exception { |
StreamExecutionEnvironment.execute(streamGraph)
1 |
|
Table API
executeInternal(transformations, sinkIdentifierNames) -> DefaultExecutor.executeAsync -> StreamExecutionEnvironment.executeAsync
1 | private TableResultInternal executeInternal( |
DefaultExecutor.executeAsync
1 | public JobClient executeAsync(Pipeline pipeline) throws Exception { |
公共部分
StreamExecutionEnvironment.executeAsync->LocalExecutor.execute->LocalExecutor.getJobGraph->PipelineExecutorUtils.getJobGraph->FlinkPipelineTranslationUtil.getJobGraph->StreamGraphTranslator.translateToJobGraph->StreamGraph.getJobGraph->StreamingJobGraphGenerator.createJobGraph
StreamExecutionEnvironment.executeAsync
1 |
|
LocalExecutor.execute
1 | public CompletableFuture<JobClient> execute( |
LocalExecutor.getJobGraph
1 | private JobGraph getJobGraph(Pipeline pipeline, Configuration configuration) |
PipelineExecutorUtils.getJobGraph
1 | public static JobGraph getJobGraph( |
FlinkPipelineTranslationUtil.getJobGraph
1 | /** Transmogrifies the given {@link Pipeline} to a {@link JobGraph}. */ |
StreamGraphTranslator.translateToJobGraph
1 | public JobGraph translateToJobGraph( |
StreamGraph.getJobGraph
1 | public JobGraph getJobGraph( JobID jobID) { |
StreamingJobGraphGenerator.createJobGraph
1 | public static JobGraph createJobGraph(StreamGraph streamGraph, JobID jobID) { |
到这里
JobGraph就生成了,它和StreamGraph都是在 Client 端生成的
小结
本文目标是学习总结从 Flink 入口到执行 Hudi 自定义 StreamOperator的逻辑的主要调用步骤,也就是研究 Flink 的 Task 或者 Function 是如何运行的。由于这块逻辑比较复杂,本文先主要总结了:
1、Flink 的 Transformation、StreamOperator
2、阐述了写Hudi逻辑与Transformation、StreamOperator的关系,知道了实际上写 Hudi 的主要逻辑就是在 Hudi 自定义的StreamOperator和SinkFunction中实现的
3、Flink的四层执行图以及相关词汇概念解释
4、StreamGraph 和 JobGraph 的生成构建过程
对于后面的ExecutionGraph、Physical Graph、JobManager和TaskManager的启动等还没有分析,等我有空时再分几篇文章来进行总结。
相关阅读
- Hudi Flink SQL源码调试学习(一)
- Hudi Flink SQL代码示例及本地调试
- Flink Hudi DataStream API代码示例
- Flink 源码阅读笔记(1)- StreamGraph 的生成
- Hudi源码|Insert源码分析总结(一)(整体流程)
本文由 董可伦 发表于 伦少的博客 ,采用署名-非商业性使用-禁止演绎 3.0进行许可。
非商业转载请注明作者及出处。商业转载请联系作者本人。
本文标题:Hudi Flink SQL源码调试学习(二)- Transformation/StreamOperator总结 - StreamGraph和JobGraph的生成过程
本文链接:https://dongkelun.com/2023/08/29/hudi/hudiFlinkSQLSourceCodeDebug2/
欢迎关注我的公众号