前些天发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,忍不住给大家分享一下。点击跳转到网站:https://www.captainai.net/dongkelun
前言
上篇文章Flink SQL操作Hudi并同步Hive使用总结总结了如何使用Flink SQL读写Hudi并同步Hive,介绍了创建表的各种方式,但是每一种方式都不太完美。本文介绍一种比较完美的方式,通过Hudi HMS Catalog读写Hudi并同步Hive表,这里的Hudi HMS Catalog实际上就是通过上篇文章最后提到的HoodieHiveCatalog实现的,PR:[HUDI-4098]Support HMS for flink HudiCatalog,2022年7月18 merge,也就是从Hudi0.12.0版本开始支持(我确认了一下0.11.1版本没有),如果大家要使用的话,必须升级到0.12.0+,本文使用Hudi master 0.13.0-SNAPSHOT。
Flink Hudi HMS Catalog的好处
既然推荐这种方式,那么先说一下它的好处吧。好处是它可以像Spark SQL创建表一样,直接将表建立在Hive中,并且表结构与Hive SQL和Spark SQL兼容,也就是Flink Hudi HMS Catalog中创建的表,可以同时使用Flink SQL、Hive SQL、Spark SQL查询,也可以同时使用Flink SQL、Spark SQL写Hudi。不像上篇文章中介绍的方式,Flink SQL写Hudi的表不能被Hive/Spark使用,只能通过同步表的方式。另外在Flink Hudi HMS Catalog中和Spark SQL一样默认开启同步Hive,也就是对于MOR表默认会同步创建对应的_ro表和_rt表,至于COW表因为同步的表名和创建的表名一样,所以读写是同一张表。总之和Spark SQL创建表、读写一致。
版本
Flink 1.14.3
Hudi master 0.13.0-SNAPSHOT
本文采用Flink yarn-session模式,不会的可以参考:Flink SQL 客户端查询Hive配置及问题解决
创建Flink Hudi HMS Catalog
先看一下如何创建Flink Hudi HMS Catalog
1 | CREATE CATALOG hudi_catalog WITH ( |
支持的配置项:
1 | catalog.path |
可以看到和hive catalog的配置项差不多,只是type为hudi,这里mode必须是hms,默认值是dfs,至于为啥是hms,请看下面的源码分析
还有一点需要注意的是hive catalog中的配置项为hive-conf-dir,但是hudi的为hive.conf.dir,看着差不多,其实不一样。
table.external:是否为外部表,默认false,也就是默认内部表,但是0.12.0和0.12.1没有这个配置项,只能是外部表,这正是我使用Hudi master 0.13.0-SNAPSHOT的原因
如果觉得这个配置不是必须的,大家可以直接用0.12.1即可
为啥mode为hms
1 | public Catalog createCatalog(Context context) { |
可以看到mode默认值为dfs,只有mode为hms时,才会使用HoodieHiveCatalog
MOR表
建表
1 | CREATE TABLE test_hudi_flink_mor ( |
使用catalog时path可以不用指定,不指定的话,路径就是Hive库路径+表名,可以看后面的Cow表。
这里需要注意的是,虽然不用配置同步Hive相关的配置,也就是默认会同步,但仍然需要配置hive_sync.conf.dir,否则依旧会报和上篇文章中一样的异常:
WARN hive.metastore [] - set_ugi() not successful, Likely cause: new client talking to old server. Continuing without it.
org.apache.thrift.transport.TTransportException: null
其实这里我认为是不合理的,因为catalog中已经配置了hive.conf.dir,这俩其实可以共用的。
这时在对应的Hive数据库中就已经建好表了,并且表结构同时兼容Hive、Spark和Flink,也就是既可以用Hive SQL查询,也可以用Spark SQL和Flink SQL读写
1 | show create table test_hudi_flink_mor; |
同步Hive
Insert几条数据,看一下会不会触发一下Hive同步
1 | insert into test_hudi_flink_mor values (1,'hudi',10,100,'2022-10-31'),(2,'hudi',10,100,'2022-10-31'); |
果然默认同步,表结构和之前的方式是一样的。同步的表默认是外部表,可以通过配置项hoodie.datasource.hive_sync.create_managed_table配置是否为外部表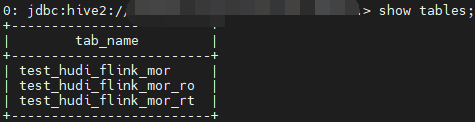
COW 表
建表
1 | CREATE TABLE test_hudi_flink_cow ( |
这里没有指定path,看一下Hive中的表结构,路径为库路径+表名:hdfs://cluster1/warehouse/tablespace/managed/hive/test_flink/test_hudi_flink_cow,这更符合平时的使用习惯,毕竟少了一个配置项,且路径统一好管理,不容易出错。
1 | +----------------------------------------------------+ |
同步Hive
1 | insert into test_hudi_flink_cow values (1,'hudi',10,100,'2022-10-31'),(2,'hudi',10,100,'2022-10-31'); |
因为名字一样,所以同步的结果看不到变化
一致性验证
通过Spark SQL分别往每个表写几条数据,再用Spark、Hive、Flink查询
1 | insert into test_hudi_flink_mor values (3,'hudi',10,100,'2022-10-31'); |
经过验证,一致性没有问题。遗憾的是,Flink SQL查询结果依旧不包含元数据字段,不清楚为啥要这样设计~
异常解决
异常信息
1 | Caused by: java.lang.NoSuchMethodError: org.apache.hudi.org.apache.jetty.util.compression.DeflaterPool.ensurePool(Lorg/apache/hudi/org/apache/jetty/util/component/Container;)Lorg/apache/hudi/org/apache/jetty/util/compression/DeflaterPool; |
异常原因,Hudi包中的jetty版本和hadoop环境下的jetty版本不一致,导致有冲突,相关PR:[HUDI-4960] Upgrade jetty version for timeline server,这个PR升级了jetty的版本。
解决思路,使hadoop环境下的jetty版本和Hudi包中的版本一致。一个方法是使Flink任务不依赖Hadoop环境下的jetty相关的jar,这里是由于配置了HADOOP_CLASSPATH,经过尝试一时无法解决。另外一个是升级Hadoop环境下的jetty版本,但是我尝试了一下,由于Hadoop环境组件依赖的jar包比较多,单纯升级jetty版本的话,会引起其他问题,无奈只能先将Hudi中jetty回退到原先的版本,最简单的方式是直接reset到这个PR之前的位置。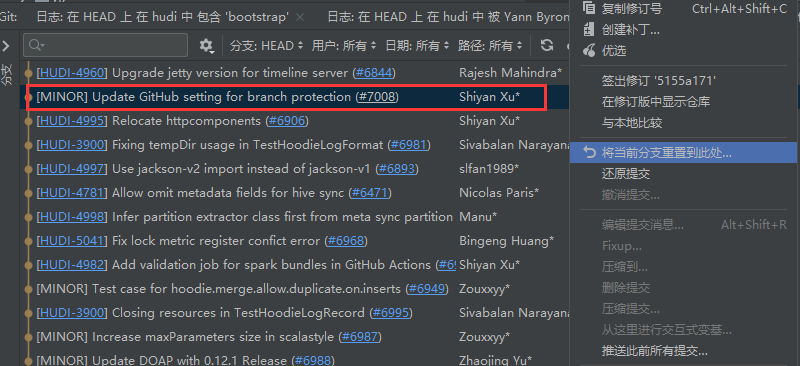
总结
本文介绍了Flink SQL如何通过Hudi HMS Catalog读写Hudi并同步Hive表,并且讲述了Hudi HMS Catalog的好处,我认为这是目前比较完美的一种方式,强烈推荐大家使用
相关阅读
本文由 董可伦 发表于 伦少的博客 ,采用署名-非商业性使用-禁止演绎 3.0进行许可。
非商业转载请注明作者及出处。商业转载请联系作者本人。
本文标题:Flink SQL通过Hudi HMS Catalog读写Hudi并同步Hive表(强烈推荐这种方式)
本文链接:https://dongkelun.com/2022/11/02/flinkHudiHmsCatalog/
欢迎关注我的公众号