前些天发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,忍不住给大家分享一下。点击跳转到网站:https://www.captainai.net/dongkelun
前言
本文利用SparkStreaming和Kafka实现基于缓存的实时wordcount程序,什么意思呢,因为一般的SparkStreaming的wordcount程序比如官网上的,只能统计最新时间间隔内的每个单词的数量,而不能将历史的累加起来,本文是看了教程之后,自己实现了一下kafka的程序,记录在这里。其实没什么难度,只是用了一个updateStateByKey算子就能实现,因为第一次用这个算子,所以正好学习一下。
1、数据
数据是我随机在kafka里生产的几条,单词以空格区分开
2、kafka topic
首先在kafka建一个程序用到topic:UpdateStateBykeyWordCount
1 | bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic UpdateStateBykeyWordCount |
3、创建checkpoint的hdfs目录
我的目录为:/spark/dkl/kafka/wordcount_checkpoint
1 | hadoop fs -mkdir -p /spark/dkl/kafka/wordcount_checkpoint |
4、Spark代码
启动下面的程序
1 | package com.dkl.leanring.spark.kafka |
5、生产几条数据
随便写几条即可
1 | bin/kafka-console-producer.sh --broker-list ambari.master.com:6667 --topic UpdateStateBykeyWordCount |
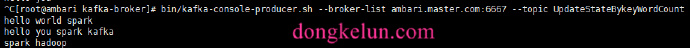
6、结果
根据结果可以看到,历史的单词也被统计打印出来了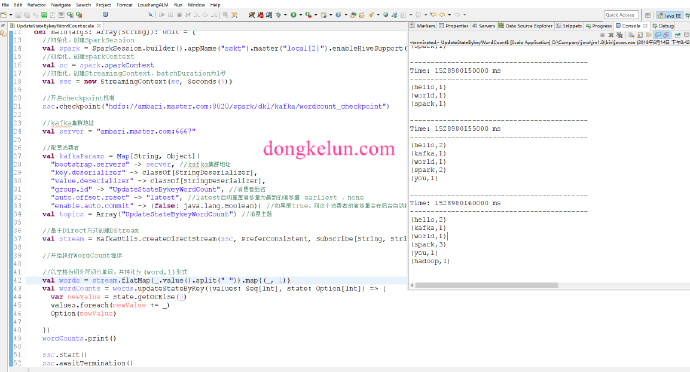
本文由 董可伦 发表于 伦少的博客 ,采用署名-非商业性使用-禁止演绎 3.0进行许可。
非商业转载请注明作者及出处。商业转载请联系作者本人。
本文标题:SparkStreaming+Kafka 实现基于缓存的实时wordcount程序
本文链接:https://dongkelun.com/2018/06/14/updateStateBykeyWordCount/
欢迎关注我的公众号