前些天发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,忍不住给大家分享一下。点击跳转到网站:https://www.captainai.net/dongkelun
前言
首先要安装好kafka,这里不做kafka安装的介绍(这里用的是ambari安装的kafka),若想了解如何安装可参考Kafka安装启动入门教程和centos7 ambari2.6.1.5+hdp2.6.4.0 大数据集群安装部署,本文是Spark Streaming入门教程,只是简单的介绍如何利用spark 连接kafka,并消费数据,由于博主也是才学,所以其中代码以实现为主,可能并不是最好的实现方式。
1、对应依赖
根据kafka版本选择对应的依赖,我的kafka版本为0.10.1,spark版本2.2.1,然后在maven仓库找到对应的依赖。
(Kafka项目在版本0.8和0.10之间引入了新的消费者API,因此有两个独立的相应Spark Streaming软件包可用)
1 | <dependency> |
我用的是sbt,对应的依赖:
1 | "org.apache.spark" % "spark-streaming-kafka-0-10_2.11" % "2.2.1" |
2、下载依赖
在命令行执行
1 | sbt eclipse |
(我用的是eclipse sbt,具体可看我的其他博客,具体命令根据自己的实际情况)
3、创建topic
创建测试用topic top1
1 | bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic top1 |
4、启动程序
下好依赖之后,根据官方文档提供的示例进行代码测试
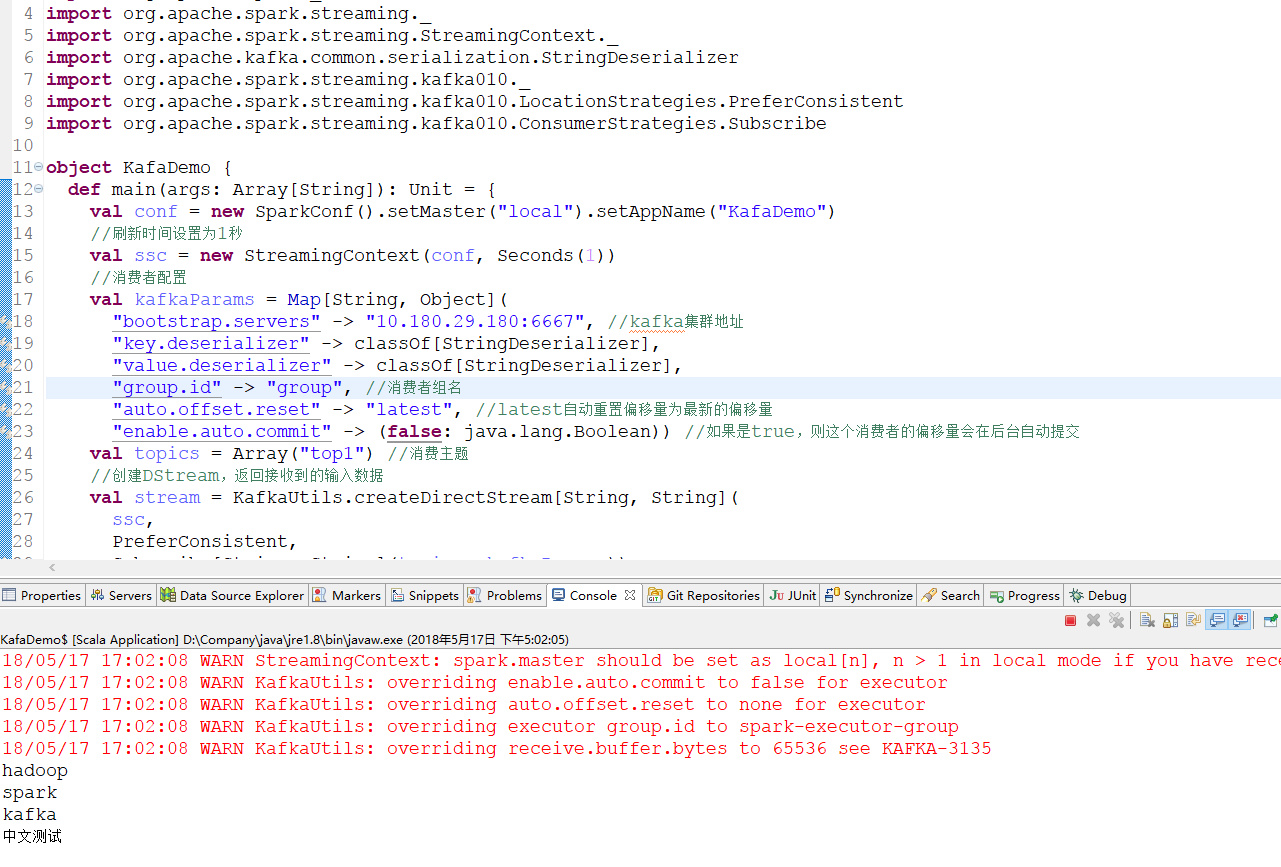
下面的代码示例,主要实现spark 连接kafka,并将接收的数据打印出来,没有实现复杂的功能。
1 | package com.dkl.leanring.spark.kafka |
启动上面的程序(本地eclipse启动即可)
其中当auto.offset.reset为latest时,直面上看只消费程序启动后产生的数据,若想获取历史数据,将auto.offset.reset改为earliest即可,下面是具体的含义解释,该解释来自:https://blog.csdn.net/lishuangzhe7047/article/details/74530417
- earliest:当各分区下有已提交的offset时,从提交的offset开始消费;无提交的offset时,从头开始消费
- latest:当各分区下有已提交的offset时,从提交的offset开始消费;无提交的offset时,消费新产生的该分区下的数据
- none:topic各分区都存在已提交的offset时,从offset后开始消费;只要有一个分区不存在已提交的offset,则抛出异常
需要记住的要点
当在本地运行一个 Spark Streaming 程序的时候,不要使用 “local” 或者 “local[1]” 作为 master 的 URL 。这两种方法中的任何一个都意味着只有一个线程将用于运行本地任务。如果你正在使用一个基于接收器(receiver)的输入离散流(input DStream)(例如, sockets ,Kafka ,Flume 等),则该单独的线程将用于运行接收器(receiver),而没有留下任何的线程用于处理接收到的数据。因此,在本地运行时,总是用 “local[n]” 作为 master URL ,其中的 n > 运行接收器的数量。
将逻辑扩展到集群上去运行,分配给 Spark Streaming 应用程序的内核(core)的内核数必须大于接收器(receiver)的数量。否则系统将接收数据,但是无法处理它。
我一开始没有看到官网提醒的这一点,将示例中的local[2]改为local,现在已经在代码里改回local[2]了,但是下面的截图没有替换,注意下。
5、发送消息
运行producer
1 | bin/kafka-console-producer.sh --broker-list ambari.master.com:6667 --topic top1 |
注意:ambari.master.com为ip的映射名,可以直接写ip,但是不能写localhost,否则远程spark获取不到,如果为localhost,则需要修改配置,具体怎么改,可参考Kafka安装启动入门教程中第七条。
然后依次发送下面几个消息
1 | hadoop |
6、结果
然后在eclipse console就可以看到对应的数据了。
1 | hadoop |
为了直观的展示和理解,附上截图:
发送消息
结果
本文由 董可伦 发表于 伦少的博客 ,采用署名-非商业性使用-禁止演绎 3.0进行许可。
非商业转载请注明作者及出处。商业转载请联系作者本人。
本文标题:Spark Streaming连接Kafka入门教程
本文链接:https://dongkelun.com/2018/05/17/sparkKafka/
欢迎关注我的公众号