前些天发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,忍不住给大家分享一下。点击跳转到网站:https://www.captainai.net/dongkelun
1、在服务器(虚拟机)spark-shell连接hive
1.1 将hive-site.xml拷贝到spark/conf里
1 | cp /opt/apache-hive-2.3.2-bin/conf/hive-site.xml /opt/spark-2.2.1-bin-hadoop2.7/conf/ |
1.2 将mysql驱动拷贝到spark/jar里
1 | cp /opt/apache-hive-2.3.2-bin/bin/mysql-connector-java-5.1.46-bin.jar /opt/spark-2.2.1-bin-hadoop2.7/jars/ |
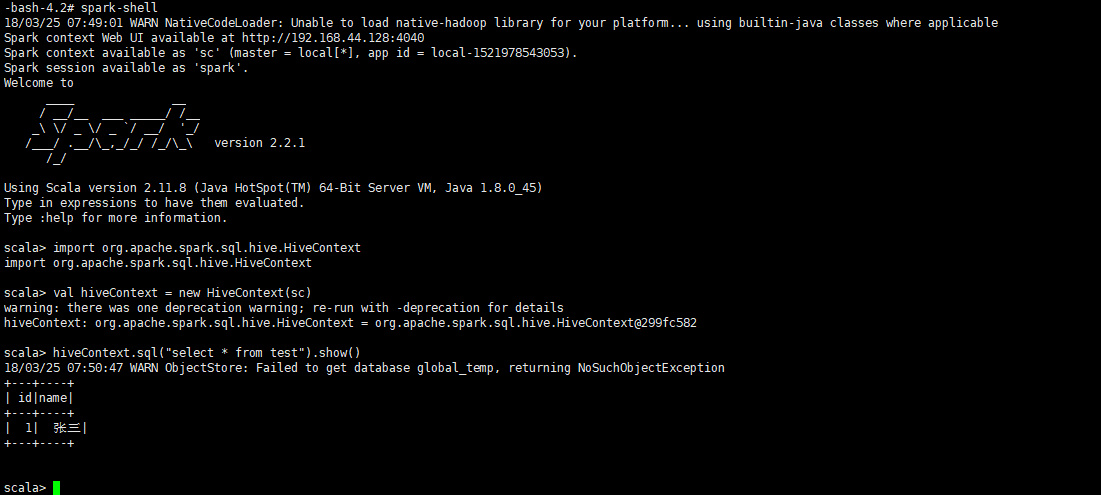
1.3 启动spark-shell,输入代码测试
1 | spark-shell |
1.4 异常及解决
在执行hiveContext.sql(“select * from test”).show() 报了一个异常:
1 | The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: rwxr-xr-x; |
解决办法:
1.4.1 更改HDFS目录/tmp/hive的权限:
1 | hadoop fs -chmod 777 /tmp/hive |
1.4.2 同时删HDFS与本地的目录/tmp/hive:
1 | hadoop fs -rm -r /tmp/hive |
这次错误采用的是第二种解决办法,有的情况下用第一种方法,比如一次在启动hive时候报这种错误~。
错误截图: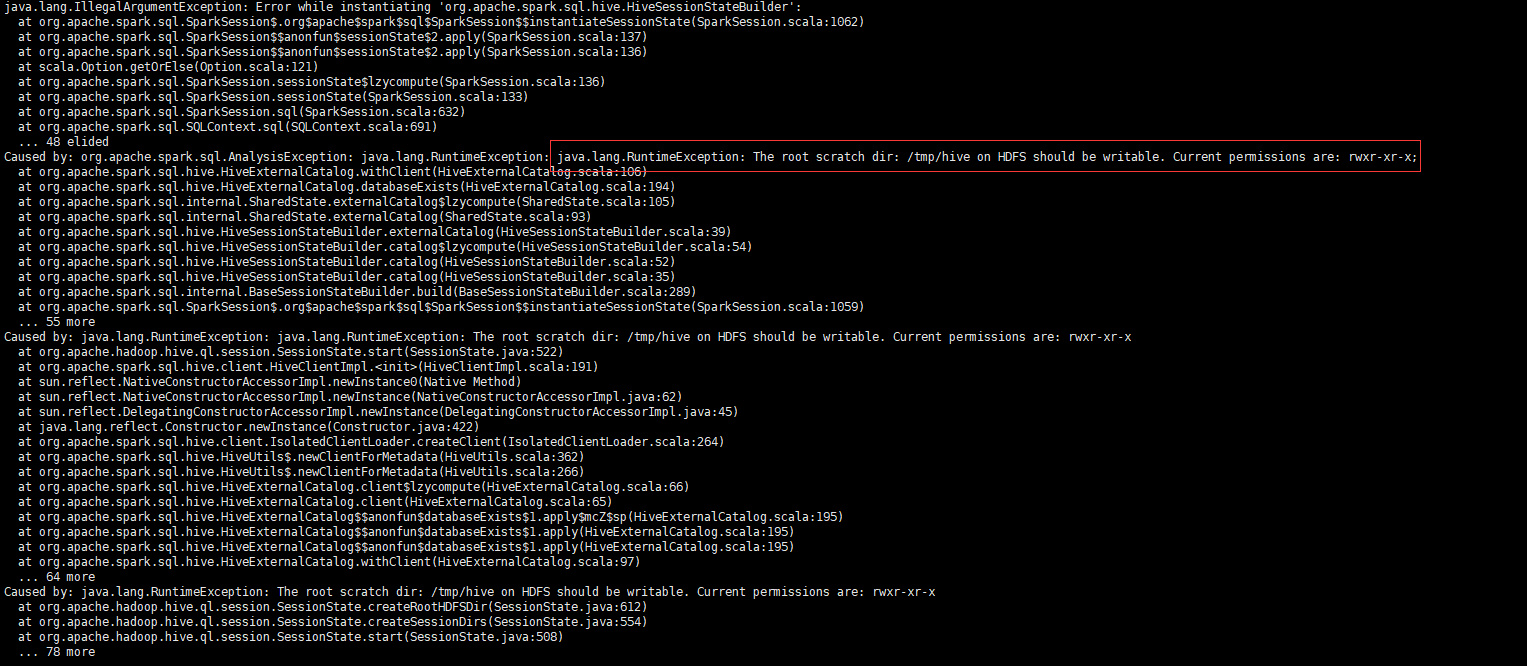
参考:http://www.cnblogs.com/czm1032851561/p/5751722.html
2、win10+eclipse上连接hive
2.1 将hive-site.xml拷贝到项目中的resources文件夹下
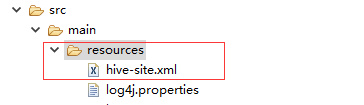
2.2 在sbt里添加对应版本的mysql依赖
1 | "mysql" % "mysql-connector-java" % "5.1.46" |
2.3 代码
2.3.1 旧版api(1.6以上)
1 | package com.dkl.leanring.spark.sql |
(注:其中df.createOrReplaceTempView(“user”)改为df.registerTempTable(“user”),因为createOrReplaceTempView方法是2.0.0才有的,registerTempTable是旧版的方法,1.6.0就有了,嫌麻烦就不改代码重新贴图了)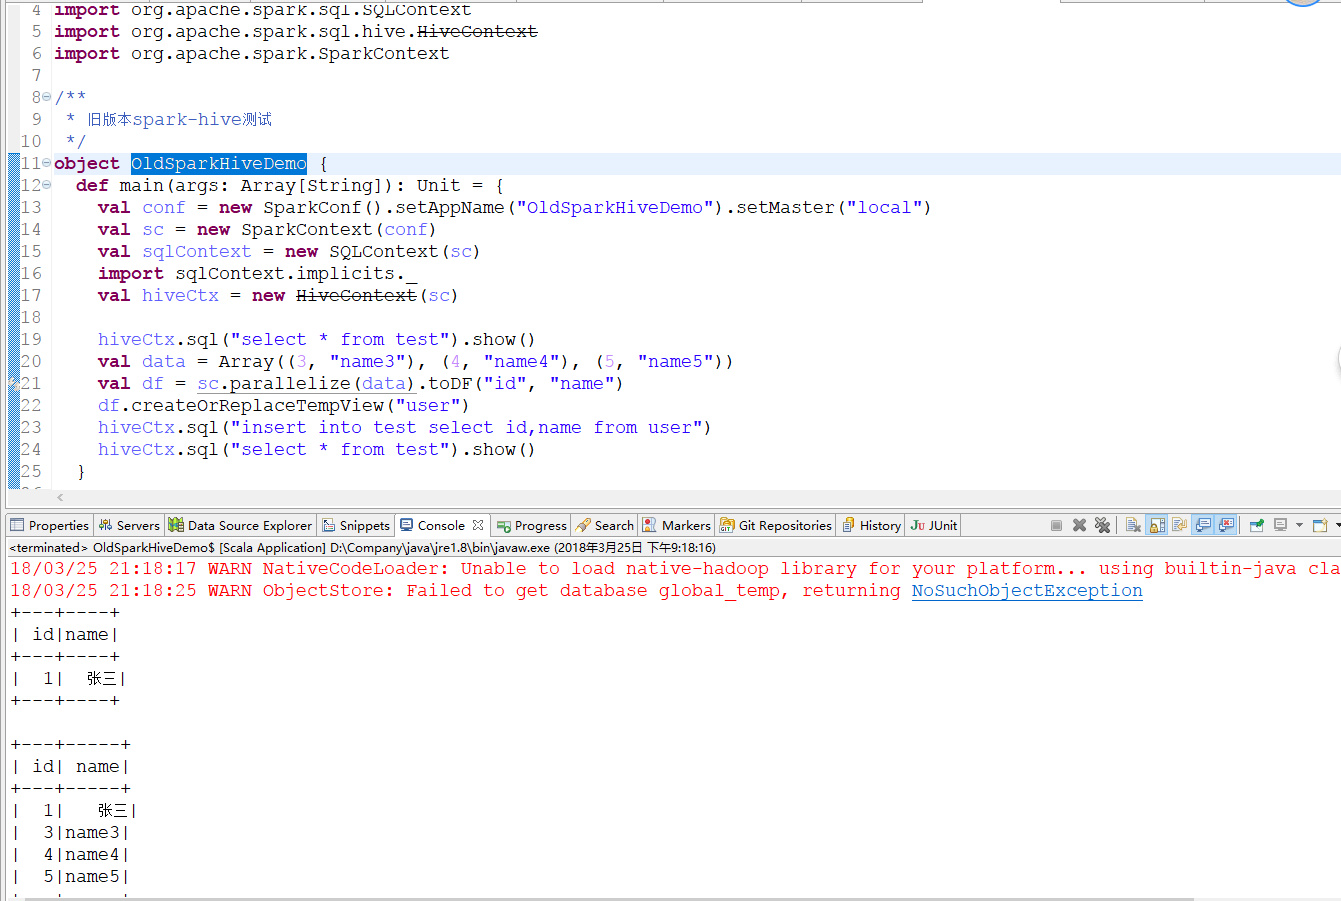
2.3.2 新版api
1 | package com.dkl.leanring.spark.sql |
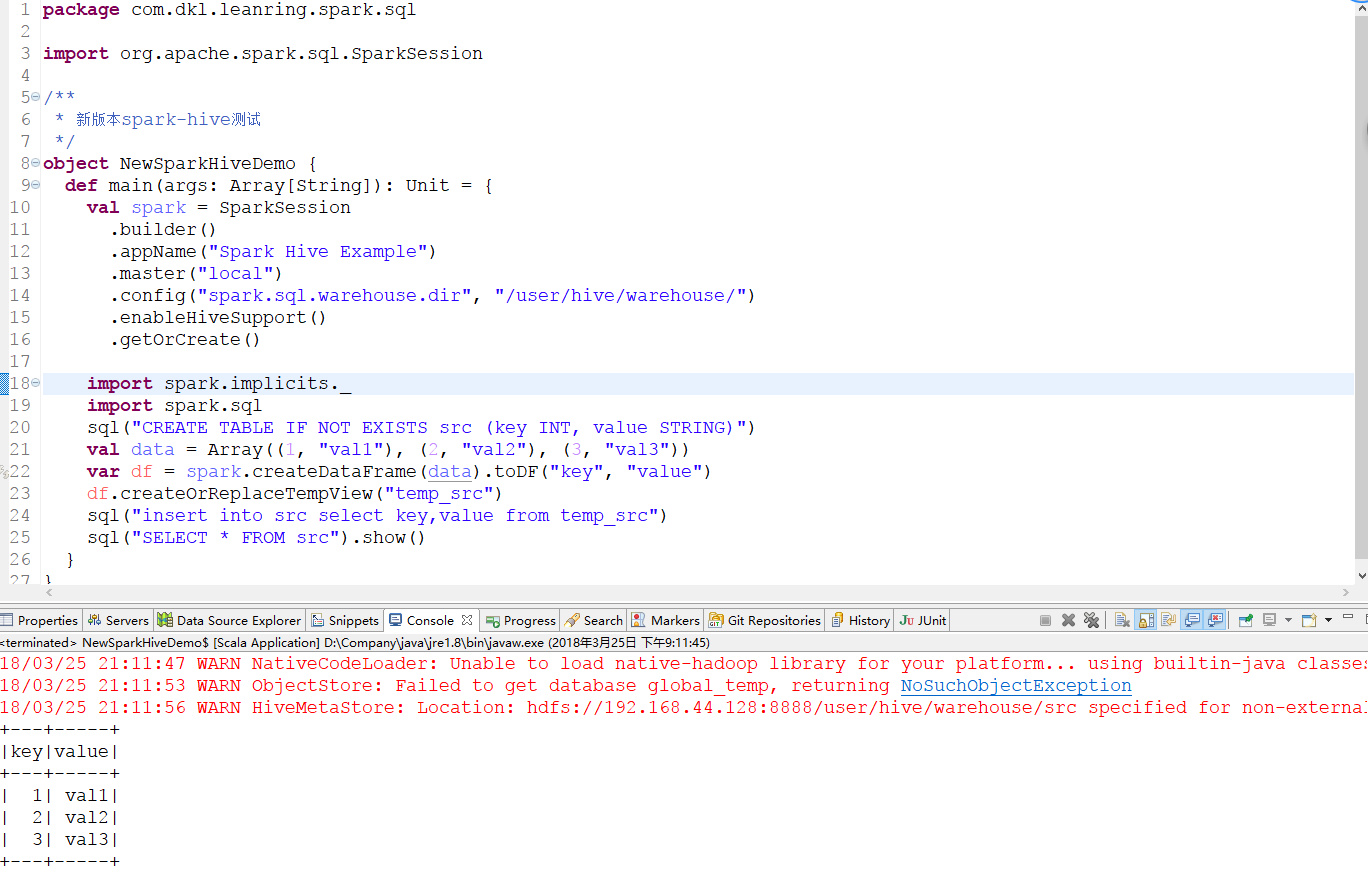
2.4 异常及解决方法
在执行insert语句时会出现如下异常信息:
1 | org.apache.hadoop.security.AccessControlException: Permission denied: user=dongkelun, access=EXECUTE, inode="/user/hive/warehouse":root... |
原因是:启动 Spark 应用程序的win用户对spark.sql.warehouse.dir没有写权限
解决办法:
1 | hadoop fs -chmod 777 /user/hive/warehouse/ |
附异常信息截图: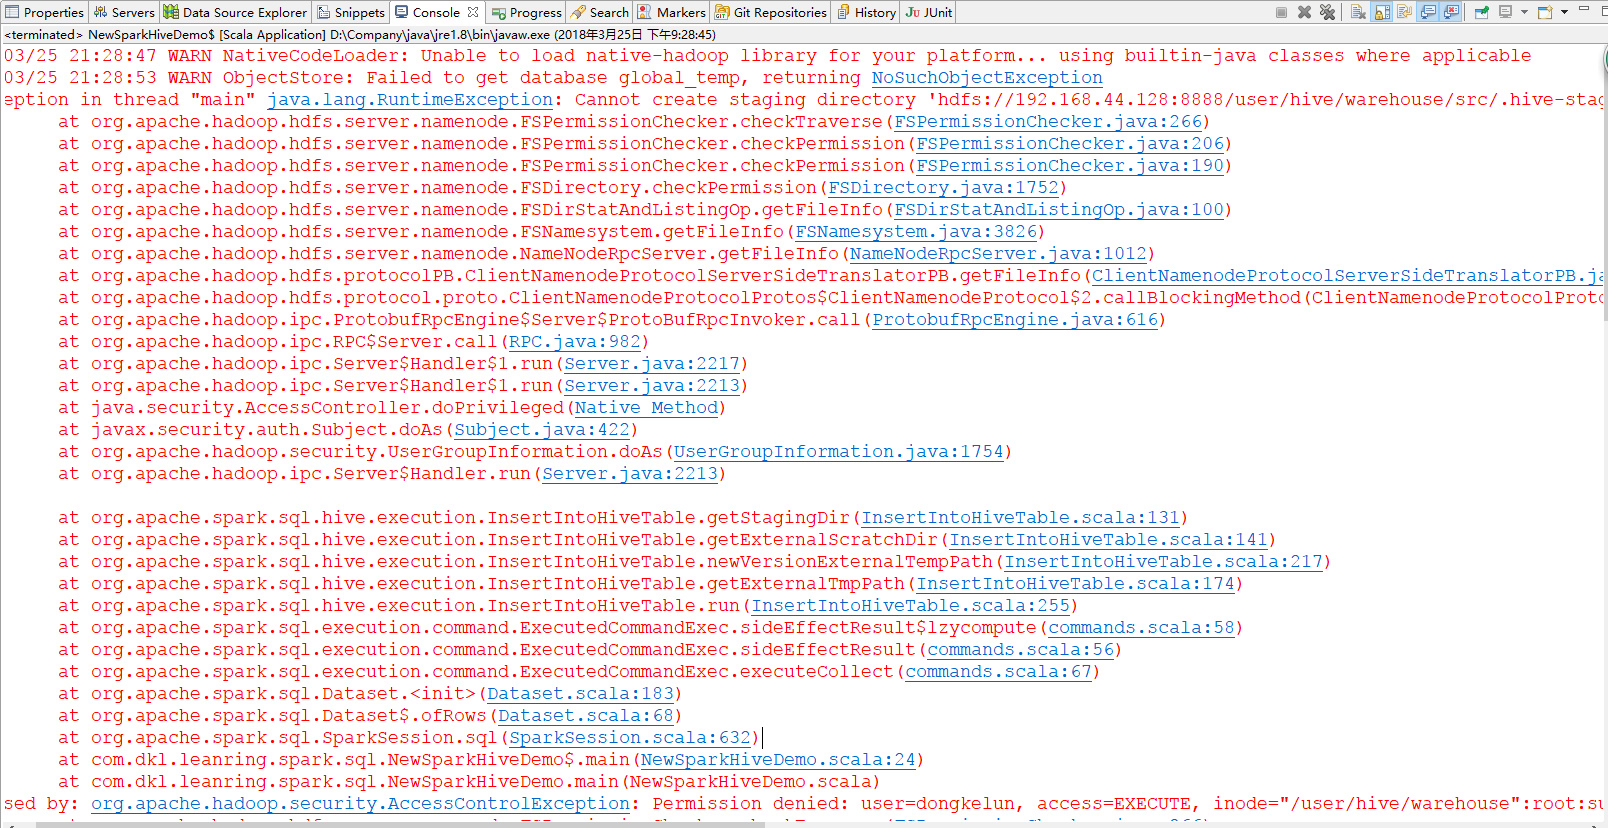
3、更新:写hive方法
直接用下面这句代码即可将df里的全部数据存到hive表里
1 | df.write.mode(SaveMode.Append).saveAsTable(tableName) |
4、更新(2018.11.29)
4.1 关于hive-site.xml
上面讲的hive-site.xml为我在博客centos7 hive 单机模式安装配置配置的。
1 |
|
后来在工作中发现可以不用将整个hive-site.xml全部拷过来,用一个metastore就可以搞定~
用下面的命令启动metastore
1 | nohup hive --service metastore & |
在nohup.out文件里看一下启动日志,如果启动成功的话,就可以将hive-site.xml改为
1 | <configuration> |
这样就可以用上面讲的代码连接Hive了,一般我都是用这种方式连接Hive,至于优缺点我没有深入研究,表面上看起来有两点
- 配置比较简单
- 不用暴漏元数据库mysql的用户名、密码等。
如何关闭metastore(Linux基础)
1 | -bash-4.2# ps aux | grep metastore |
4.2 另一个读取hive表的简单方法
用下面这行代码就可以读取整个Hive表了
1 | spark.table("test") |
4.3 关于上面的代码
下面这个配置可以去掉
1 | .config("spark.sql.warehouse.dir", "/user/hive/warehouse/") |
本文由 董可伦 发表于 伦少的博客 ,采用署名-非商业性使用-禁止演绎 3.0进行许可。
非商业转载请注明作者及出处。商业转载请联系作者本人。
本文标题:Spark连接Hive(spark-shell和Eclipse两种方式)
本文链接:https://dongkelun.com/2018/03/25/sparkHive/
欢迎关注我的公众号