前言
记录一下vmware如何克隆一个虚拟机,并解决克隆的centos7虚拟机遇到的网络问题
克隆方法
右键点击要克隆的虚拟机->管理->克隆,然后下一步->下一步,克隆类型选择创建完整克隆->输入虚拟机名称,选择位置,点击完成,然后等待一直到完成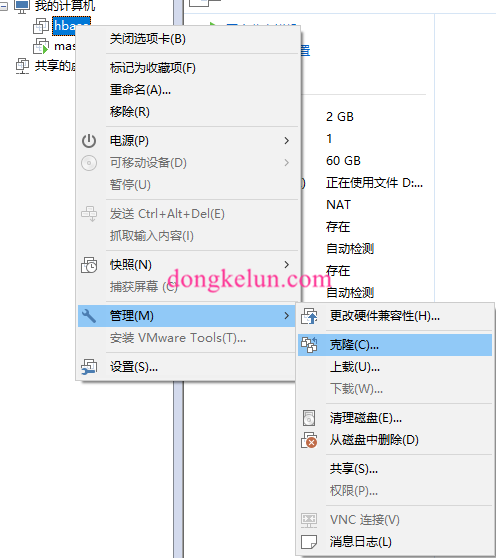
记录一下vmware如何克隆一个虚拟机,并解决克隆的centos7虚拟机遇到的网络问题
右键点击要克隆的虚拟机->管理->克隆,然后下一步->下一步,克隆类型选择创建完整克隆->输入虚拟机名称,选择位置,点击完成,然后等待一直到完成
先说解决办法,提交时除了添加spark-sql-kafka和kafka-clients jar包外,还要添加spark-token-provider-kafka和commons-pool jar包,具体为spark-token-provider-kafka-0-10_2.12-3.0.1.jar和commons-pool2-2.6.2.jar
注意:Spark 3 版本和Spark 2有些不一样,提交Structured Streaming需要注意Kafka client 版本需要>=0.11.0.0,这个在spark官方文档里有说明:Please note that to use the headers functionality, your Kafka client version should be version 0.11.0.0 or up.
记录一下Java API 连接 Hbase的代码,并记录遇到的异常及解决办法
首先pom.xml里添加hbase-client依赖:
1 | <dependency> |
然后将hbase-site.xml,core-site.xml复制到本地(如果实在本地运行的话)
more >>因后续要学习研究hbase,那就先从搭建hbase开始吧。先搭建一个单机版的,方便自己学习使用。
参考我的另一篇文章:centos7 hadoop 单机模式安装配置
注:这里的JDK为1.8,版本支持如图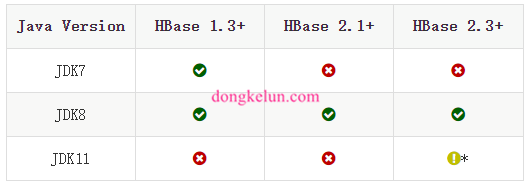
缺失模块。
1、请确保node版本大于6.2
2、在博客根目录(注意不是yilia根目录)执行以下命令:
npm i hexo-generator-json-content --save
3、在根目录_config.yml里添加配置:
  jsonContent:
    meta: false
    pages: false
    posts:
      title: true
      date: true
      path: true
      text: false
      raw: false
      content: false
      slug: false
      updated: false
      comments: false
      link: false
      permalink: false
      excerpt: false
      categories: false
      tags: true